【G検定対策】教師あり学習の重要用語を網羅!一発合格を目指す記憶法
※本記事では、アフィリエイトプログラムより教材を紹介しています。
【重要度】★★★
「G検定のシラバスを見たけれど、教師あり学習のアルゴリズムが多すぎて頭がパンクしそう…」
「単回帰、重回帰、ロジスティック回帰…名前が似ていて違いがさっぱり分からない!」
「数学やプログラミングの経験がない自分には、アンサンブル学習なんて難しすぎる…」
あなたも、このような悩みを抱えていませんか?
G検定において、「教師あり学習」は全問題の中でも最も出題比率が高く、合否を分ける超重要ジャンルです。
カタカナやアルファベットの専門用語が津波のように押し寄せてくるため、丸暗記しようとすると高確率で挫折します。
しかし、安心してください!
教師あり学習のモデルは、「日常の身近な例え話(メタファー)」に置き換えることで、数式を一切使わなくても直感的に記憶に焼き付けることができます。
この記事を読めば、試験で狙われる重要キーワードの意味や違いがスッキリ理解でき、得点源に変わります。
しっかりと読み込んで、最短ルートで合格への切符をつかみ取りましょう!
1. 教師あり学習とは?分かりやすい例え話で解説
機械学習の王道である「教師あり学習」を一言で表すと、「『問題』と『模範解答』がセットになった過去問集を使って、ひたすら受験勉強をするスタイル」です。
私たちが資格試験の勉強をするとき、問題だけを見ても正解は分かりませんよね。
「問題」を解き、後ろのページの「解答と解説」を確認して、「なるほど、こういうパターンのときはこれが正解になるんだな」と法則性を学びます。
このプロセスを何百回、何千回と繰り返すことで、本番の試験で見たことがない新しい問題が出ても、正しい答えを導き出せるようになります。
AIの学習もこれとまったく同じです。
AIに対して、事前に「データ(問題)」と「正解ラベル(答え)」のペアを大量にインプットします。
- 特徴量(問題):AIが予測を行うための「問題文」となるデータの性質や特徴のこと。(例:家賃を予測したい場合の「駅からの徒歩分数」「部屋の広さ」「築年数」など)
- 教師データ / 正解ラベル(答え):AIに当ててほしい「目標」となるデータのこと。(例:「家賃12万円」という実際の答え)
AIはこの「特徴量」と「教師データ」の関係性を必死に計算し、両者を結びつける「ルール(数式や境界線)」を自ら導き出します。
初心者がつまずきやすいポイント:2つのタスク
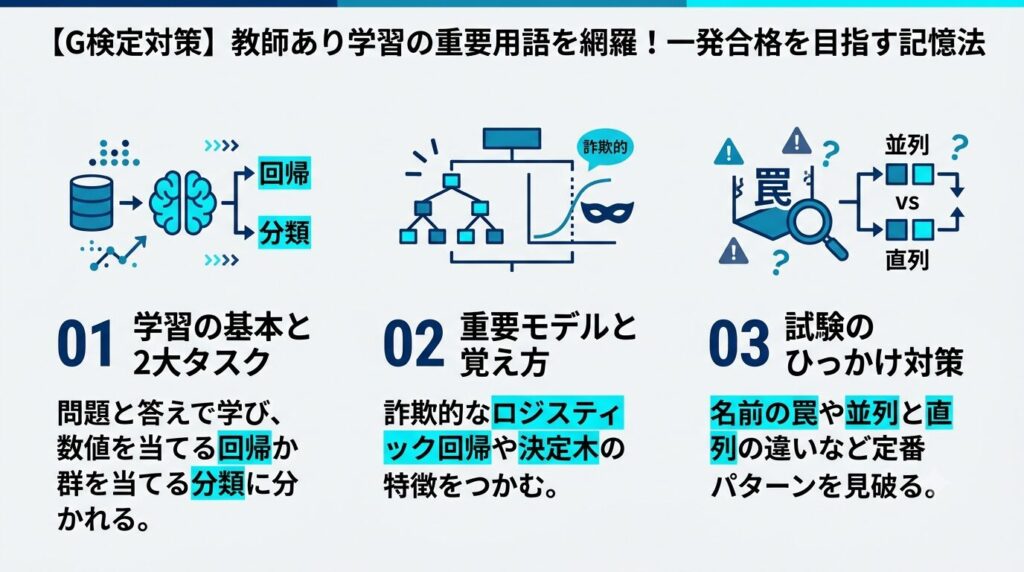
教師あり学習が解く問題は、大きく分けて「回帰問題」と「分類問題」の2つしかありません。
ここがすべての土台になります。
1. 回帰問題(数値を当てる)
明日のみかんの価格、来月の売上、スカイツリーの周辺の家賃など、「連続する具体的な数値」をぴったり予測するタスクです。
例えるなら、テストで「何点取れるか」を予想するようなものです。
2. 分類問題(グループを当てる)
届いたメールが「スパムか・通常か」、画像に写っているのが「犬か・猫か」など、「あらかじめ決まったカテゴリ(離散値)」に振り分けるタスクです。
例えるなら、テストの結果が「合格か・不合格か」を予想するようなものです。
試験では、「この具体的なビジネス事例は、回帰と分類のどちらにあてはまるか」がよく問われます。
「予測したいゴールが『数字』なのか『グループ』なのか」という視点を持つだけで、迷うことはなくなります。
2. 試験に出る!最重要キーワードの解説と覚え方
ここからは、G検定のシラバスに登場する「教師あり学習」の最重要キーワードを、1つずつ丁寧に解説していきます。
試験に出るポイントを凝縮しているので、しっかりチェックしてください。
特徴量と教師データ(正解ラベル) ★★★
前述の通り、教師あり学習のエンジンとなるデータです。
試験では「教師あり学習には、特徴量と教師データのペアが必要である」という文章の正誤問題が頻出します。
これがないと、AIは「何が正解か」を学ぶことができません。
回帰問題 ★★★
連続する数値を予測するタスクです。
株価や売上、気温の予測など、答えが「15.5」や「200,000」のように無限に存在する数値データである場合、すべて回帰問題に分類されます。
分類問題(多クラス分類) ★★★
データをあらかじめ決められた枠組み(クラス)に割り当てるタスクです。
「YESかNOか」の2つに分けるものを「2クラス分類」、犬・猫・鳥・パンダのように3つ以上のグループに分けるものを「多クラス分類」と呼びます。
線形回帰(単回帰分析・重回帰分析) ★★☆
データにすーっときれいな「直線」を引くことで、未来の数値を予測する最もシンプルで古典的な手法です。
- 単回帰分析:1つのヒント(説明変数)からゴールを予測します。(例:「お店の広さ」だけで「売上」を予測する)
- 重回帰分析:複数のヒント(説明変数)を組み合わせてゴールを予測します。(例:「お店の広さ」+「駅からの距離」+「周辺の人口」から「売上」を予測する)
💡 覚え方メタファー:
「家賃を決めるとき、部屋の広さ(1つの要素)だけでなんとなく直線を引いて決めるのが『単回帰』。
広さも, 築年数も、駅からの距離も(複数の要素を)考慮して、立体的なグラフで複雑に決めるのが『重回帰』」と覚えましょう。
ロジスティック回帰 ★★★
【G検定で最大級のひっかけ単語】です。
名前に「回帰」という文字が入っていますが、実際に行うタスクは「分類問題」です。
ここを勘違いしている受験生を落とす問題が、毎回必ずと言っていいほど出題されます。
具体的には、「ある事象が発生する確率」を0から1の間の数値(シグモイド関数を使用)で計算し、「確率が50%以上だから合格(YES)」「50%未満だから不合格(NO)」というように、最終的にデータを2つのグループに分類します。
💡 覚え方メタファー:
「名前は『回帰(数値を当てる)』の皮をかぶっているけれど、中身は『合格か不合格かを決める分類のプロ』。
詐欺師のような名前のギャップ」として記憶に刻んでください。
サポートベクターマシン(SVM) ★★★
境界線の引き方が最高に男前で、非常に予測精度の高い強力なアルゴリズムです。
主に分類問題で使われますが、回帰にも応用できます。
試験では以下の3つのセット用語が問われます。
- マージン最大化:データを2つのグループに分ける境界線を引くとき、各クラスのサポートベクトル(境界に最も近いデータ点)と識別境界との距離(マージン)を最大化するようにど真ん中に境界線を引くこと。
- カーネル法:データが複雑に入り組んでいて、直線(平面)ではどうしても2つにきれいに切り分けられないとき、「データを一瞬、高次元の空間に放り投げて、別の角度から見ることで、すぱっと直線で切れるようにする」という魔法のような数学的テクニックです。これによって、複雑なデータも計算負荷を抑えて分類できるようになります。
💡 覚え方メタファー:
「散らばった赤と青のオセロの駒を、机の上(2次元)では直線で分けられないから、机をドン!と叩いて駒を宙に浮かせ(高次元化=カーネルトリック)、浮いた瞬間に下敷きでスパッと2つにセパレートする」イメージです。
決定木(ディシジョンツリー) ★★☆
「もし〜ならA、そうでなければB」という条件分岐を、木の枝分かれ(ツリー構造)のように繰り返して、最終的な答えにたどり着く手法です。
非常に構造がシンプルで、「なぜAIがその結論に至ったのか」という予測の理由(解釈性)を人間が目で見て理解しやすいという最大のメリットがあります。
💡 覚え方メタファー:
雑誌の心理テストにある「YES・NOチャート」そのものです。
「男性ですか? → YES → 30代ですか? → NO…」と進むあの形です。
アンサンブル学習 ★★★
1つの強力なAIモデルを作るのではなく、「性能はそこそこの複数のAIモデルを作って、それらの意見を多数決や平均によって統合して1つの強力な結論を出す」というアプローチです。
ことわざの「三人寄れば文殊の知恵」を地で行くスタイルで、過学習を防ぎ、予測精度を高めることができます。
アンサンブル学習には、データの組み合わせ方によっていくつかの手法があります。
試験には以下の用語がセットで出ます。
- ブートストラップサンプリング:手元にあるデータから、重複を許して(何度も同じデータを引いていいルールで)ランダムにデータを小分けにしていくデータ収集方法のこと。
- バギング:ブートストラップサンプリングで集めた小分けのデータを使って、複数のモデルを「同時(並列)」に学習させ、最後にその全員の予測を「多数決(分類)」や「平均(回帰)」でまとめる手法です。代表例が後述の「ランダムフォレスト」です。
- ブースティング:モデルを同時に学習させるのではなく、「1個目のモデルが間違えた難しい問題を、2個目のモデルが重点的に学び、2個目も間違えた問題を3個目が学ぶ…」というように、順番(直列)にモデルを育てていく手法です。前のモデルの失敗(誤差)を次のモデルが引き継ぐため、非常に強いモデルが生まれますが、計算に時間がかかります。代表例が「勾配ブースティング」です。
💡 覚え方メタファー:
「みんなでせーので一斉に問題を解いて多数決をとる、チームワーク重視の並列型が『バギング』。
先輩の失敗を後輩がノートで引き継いで、どんどんエリートをリレー形式で育てていく直列型が『ブースティング』」です。
ランダムフォレスト ★★★
バギングの超進化系です。
たくさんの「決定木」を並列にたくさん作り、それらをまとめて広大な「森(フォレスト)」にするからランダムフォレストと呼びます。
データをランダムに変えるだけでなく、決定木の枝分かれに使う「特徴量(ヒント)」自体もランダムに制限して学習させます。
これにより、それぞれの「木」が全く違う個性を持つようになり、森全体として多数決を取ったときの予測精度が高まります。
勾配ブースティング ★★★
ブースティングの超進化系です。
前の決定木の予測と正解データの「誤差」を計算し、その誤差を埋めるために次の決定木を作成し、誤差が減る方向を探索するというプロセスを何度も繰り返します。
現在、ディープラーニング以外の機械学習(テーブルデータなどの分析)において、高度な精度を誇るアルゴリズム(XGBoostやLightGBMなど)のベースとなっている技術です。
G検定でもトレンドとしてよく狙われます。
自己回帰モデル(ARモデル)・ベクトル自己回帰モデル(VARモデル) ★☆☆
これらは「時系列データ(時間の経過とともに変化するデータ)」を扱うための特殊な回帰モデルです。
- 自己回帰モデル(ARモデル):「自分の過去のデータ」を使って「自分の未来」を予測します。(例:昨日と一昨日の『自社の株価』から、今日の『自社の株価』を予測する)
- ベクトル自己回帰モデル(VARモデル):ARモデルの進化系で、「自分の過去」だけでなく、「関係のある他人の過去のデータ」も複数(ベクトルとして)取り込んで未来を予測します。(例:自社の株価だけでなく、『為替レート』や『競合他社の株価』の過去データも混ぜて、今日の『自社の株価』を予測する)
3. 【要点整理】教師あり学習モデルの特性比較一覧表
試験直前の見直しに最適!
これまで解説した重要モデルの性質や違いを、1つの表にしました。
スマホでスクロールしながら脳内を整理してください。
| モデル名 | 主なタスク | 学習の進め方 | メリット・特徴 | デメリット・弱点 |
|---|---|---|---|---|
| 線形回帰 | 回帰 | データに直線を引く | 計算が非常に高速、シンプル | 複雑な曲線のデータには対応できない |
| ロジスティック回帰 | 分類 | 確率(0〜1)を計算して分ける | 名前に「回帰」とつくが分類問題用 | 境界線が直線的なものしか扱えない |
| サポートベクターマシン(SVM) | 分類 (回帰) | マージンを最大化する | 境界線付近の予測精度が極めて高い | データ数が膨大になると計算が重い |
| 決定木 | 分類・回帰 | 条件分岐を繰り返す | 人間が見て「なぜか」を理解しやすい | データの変化に弱く、過学習しやすい |
| ランダムフォレスト | 分類・回帰 | 決定木を並列(バギング)で集める | データ変化やノイズに強く、過学習にも強い | 中身が複雑化し「なぜ」が分かりにくい |
| 勾配ブースティング | 分類・回帰 | 決定木を直列(ブースティング)で育てる | ディープラーニング以外の通常データで最強クラスの精度 | パラメータ調整が難しく、計算に時間がかかる |
4. G検定の「ひっかけ問題パターン」を総チェック!
G検定では受験生が用語の本質を理解しているかを確かめるため、巧妙な「単語の入れ替えひっかけ問題」を仕込んできます。
以下のパターンを事前に脳内にインストールしておけば、試験会場でニヤリと笑えるはずです。
🚨 ひっかけパターン①:名前のトラップ
* ❌ 誤った選択肢の例:ロジスティック回帰は、株価や売上などの連続する具体的な数値を予測する「回帰タスク」において広く用いられる。
* ⭕ 正しい見極め方:ロジスティック回帰のゴールは数値の予測ではなく、「分類(スパムか否か、合格か否か)」です!
「回帰」という名前にだまされてはいけません。
🚨 ひっかけパターン②:並列(同時)か、直列(順番)か
* ❌ 誤った選択肢の例:アンサンブル学習における「ブースティング」とは、ブートストラップサンプリングによって作成した複数のデータセットに対し、複数の学習器を同時に並列で学習させ、その結果を多数決で統合する手法である。
* ⭕ 正しい見極め方:これは「バギング」の定義です。
* バギング = 同時に並列(多数決・平均)
* ブースティング = 前の失敗を修正するように順番に直列(リレー形式)
この2つの定義をあべこべにひっくり返す問題は、G検定の超大好物です。
🚨 ひっかけパターン③:マージンの意味
* ❌ 誤った選択肢の例:サポートベクターマシンにおける「マージン最大化」とは、決定境界線から最も離れた位置に存在するデータ点との距離を最大にすることを目指すものである。
* ⭕ 正しい見極め方:最も離れたデータではなく、境界線に「最も近い位置にあるデータ点(サポートベクトル)」との隙間(マージン)を最大にします。
遠くのデータはどうでもよく、境界線ギリカタの境界を守ることが大切なのです。
🚨 ひっかけパターン④:単回帰と重回帰の主語すり替え
* ❌ 誤った選択肢の例:単回帰分析は複数の説明変数を用いて1つの目的変数を予測し、重回帰分析は1つの説明変数を用いて目的変数を予測する。
* ⭕ 正しい見極め方:説明変数の数が完全に「逆」になっています。
* 説明変数が「単(1個)」だから単回帰分析。
*説明変数が「重(たくさん)」だから重回帰分析です。
🔥 まとめ:一歩ずつ、確実に知識を血肉にしよう!
お疲れ様でした!
教師あり学習の広大な範囲を、一気に駆け抜けましたね。
最初は記号や数式のように見えていた専門用語も、「詐欺師のような名前のロジスティック回帰」「オセロを宙に浮かせるSVM」「三人寄れば文殊の知恵のアンサンブル学習」といったイメージで捉えることで、ぐっと身近に感じられたのではないでしょうか。
G検定は暗記量が多くて圧倒されそうになりますが、本質的な「仕組み」と「違い」さえつかんでしまえば、本番のひっかけ問題にも動じる必要はまったくありません。
この調子で、次のステップへ進みましょう!
【大人気💡】過去問風ミニテスト&関連テキスト
「教師あり学習」はバッチリ理解できましたか?
知識を確実に定着させて一発合格を引き寄せるために、今のあなたに最適なステップを選んで進んでみましょう!
合格率をグッと上げる!「過去問風ミニテスト」に挑戦
解説を読んだら、さっそく問題に挑戦して実力を確かめてみましょう!
ボタンをクリックするとミニテストのページが開きます。
🚀 最短ルートで合格を目指す!「厳選参考書」参考書をチョイス
G検定合格へのロードマップは、この一冊を机に置くことから始まります。
まずは目次だけでもチェックしてみてください。
知識を『覚えたつもり』で終わらせない。
この1冊を解き終える頃には、合格ライン突破に確実に近づきます。
関連項目の解説テキストを確認
- 教師なし学習を完全攻略!クラスタリングと次元削減の超分かりやすい覚え方
- モデルの選択・評価(せっかく作った教師あり学習モデル、どうやって点数評価する?)