【G検定対策】AIの安全性とセキュリティを徹底解説!攻撃手法と防御策の覚え方
※本記事では、アフィリエイトプログラムより教材を紹介しています。
【重要度】★★★
「Adversarial Attack(敵対的攻撃)って具体的に何をするの?」
「データ汚染やモデル窃取の違いがややこしくて覚えるのが大変…」と悩んでいませんか?
従来のITシステムに対するセキュリティ対策(サイバー攻撃対策)とは異なり、AI(ディープラーニング)特有の構造的な弱点を狙った攻撃手法が存在します。
この記事では、G検定の超重要テーマである「AIの安全性とセキュリティ」について、日常生活の例え話を交えてわかりやすく解説します。
試験に頻出する攻撃用語やセキュリティ・バイ・デザインの重要ポイント、ひっかけ問題のパターンまでスッキリ整理して得点源に変えましょう!
1. AIの安全性とセキュリティとは?分かりやすい例え話で解説
従来のWebサイトやデータベースへの攻撃といえば、「パスワードを破る」「ウイルスを感染させる」といった手法が主流でした。
しかし、AIシステムにおいては「AIの予測能力や学習プロセスそのものを狂わせる・盗む」という、AIならではの特殊な攻撃が存在します。
なぜAI特有の攻撃が成り立つのかというと、ディープラーニングが「人間には理解できない複雑な数学計算(パラメータ)」に基づいて判断を下しているからです。
人間の目には見えないほんのわずかなノイズを加えるだけで、AIの判断を大きく狂わせることができてしまいます。
ここで、AIに対する主な攻撃パターンを身近な「自動調理ロボットとレストラン」に例えてみましょう!
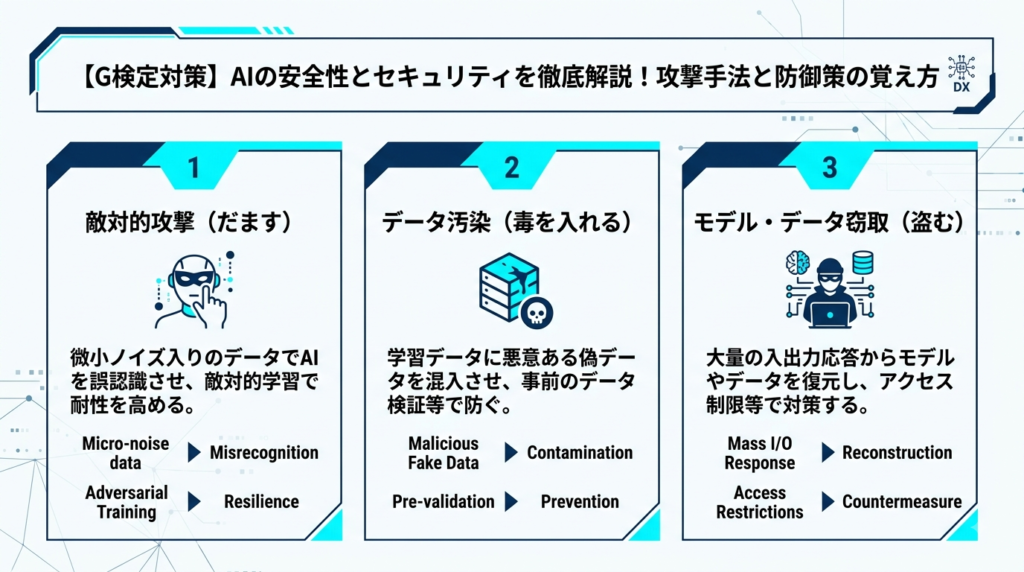
- ① 敵対的攻撃 / Adversarial Attack(AIの錯覚トリック)
自動調理ロボットに「リンゴ」を認識させるとき、表面に人間には見えない微小なシールを貼ります。
人間が見ればどう見ても「リンゴ」ですが、ロボットの画像認識センサーはパニックを起こし「これは包丁だ!」と誤認してしまいます。
このように、入力データに特殊なノイズを混ぜてAIをだます攻撃です。 - ② データ汚染・モデル汚染 / Poisoning Attack(毒レシピの混入)
ロボットが学習するための「料理のレシピ本(学習データ)」に、悪意ある第三者がこっそり間違ったレシピ(毒データ)を混ぜ込んでおきます。
すると、ロボットは間違ったレシピをそのまま覚えてしまい、特定の注文が入ったときだけ変な料理(誤作動)を作ってしまいます。 - ③ モデル窃取・データ窃取 / Extraction Attack(秘伝のタレの完コピ)
ライバル店舗の人が、レストランで何度も料理を注文して味や成分を細かく分析します。
その分析結果をもとに、厨房の中を見ることなく「秘伝のレシピ(モデルや学習データ)」をそのまま復元して盗み出してしまいます。
このように、AIへの攻撃は「だます」「毒を入れる」「盗む」の3タイプに分けられるとイメージすると、用語がスッキリ整理できますよね!
2. 試験に出る!最重要キーワードの解説と覚え方
G検定のシラバスに登場する「安全性とセキュリティ」の最重要キーワードについて、試験で問われるポイントを解説します。
Adversarial Attack(敵対的攻撃) / Adversarial Examples(敵対的サンプル)
Adversarial Examples(敵対的サンプル)とは、画像や音声などのデータに、人間の目や耳では認識できないほどの微小なノイズを加えることで、AIモデルだけに誤認識を起こさせるように作られたデータのことです。
この敵対的サンプルを用いてAIを誤作動させる攻撃全般をAdversarial Attack(敵対的攻撃)と呼びます。
- 具体例: 「パンダ」の画像に特殊なノイズを加えると、人間には依然としてパンダに見えるのに、画像認識AIは高確率で「テナガザル」と誤認識してしまう現象。
- 試験対策ポイント: 敵対的攻撃への対策として、あらかじめ敵対的サンプルを学習データに混ぜてモデルを堅牢にする「敵対的学習(Adversarial Training)」が有効であることがよく問われます。
データ汚染(Data Poisoning)/ モデル汚染(Model Poisoning)
学習フェーズ(トレーニング段階)において、AIモデルに悪意のある偽データや不正なラベルを意図的に混入させる攻撃です。
- データ汚染(Data Poisoning): 学習用データセットの中に不正なデータを紛れ込ませ、モデルの予測精度全体を低下させたり、特定の条件下で意図的な誤出荷やバックドア動作(裏口動作)を引き起こさせたりする攻撃。
- モデル汚染(Model Poisoning): 連合学習(Federated Learning)などの分散学習において、悪意のある端末が不正なモデルの更新情報を送信し、全体の共有モデルを汚染・破壊する攻撃。
- 試験対策ポイント: 「運用段階(推論時)」の攻撃であるAdversarial Attackに対して、データ汚染は「学習段階(開発時)」の攻撃であるという発生タイミングの違いを整理しておきましょう!
データ窃取(Data Extraction / Data Leakage)
AIモデルに対して大量の入力データを送信し、返ってくる出力結果(予測確率や応答)を統計的に分析することで、AIが学習に使った非公開のプライベートデータ(個人情報や機密文章など)を逆算して再現・復元する攻撃です。
- 具体例: 大規模言語モデル(LLM)に対して特殊なプロンプトを繰り返し入力し、学習データに含まれていた個人情報や機密パスワードを吐き出させる攻撃。
モデル窃取(Model Extraction)
攻撃対象のAIモデルに対して何度も入力を送り、その出力(予測ラベルや確率値)のペアを集めることで、ターゲットとなっているAIモデルと同等の性能を持つ「コピーモデル(蒸留モデル)」を無断で再現・構築する攻撃です。
- なぜ脅威なのか?: 企業が多大な開発コストと膨大なデータを投じて作った商用AIモデル(知財)が、API経由で簡単に複製(盗掘)されてしまう危険性があるためです。
セキュリティ・バイ・デザイン(Security by Design)
セキュリティ・バイ・デザインとは、AIシステムやソフトウェアの開発プロセスにおいて、企画・設計の初期段階からセキュリティ対策を考慮して開発を進める設計思想のことです。
- 特徴: システム完成後にセキュリティ対策を追加しようとすると、構造上の欠陥を簡単に修復できず改修コストが膨大になります。
最初からセキュリティを組み込むことで、堅牢で安全なAIシステムを低コストかつ確実に構築できます。 - 覚え方: 前章で学んだ「プライバシー・バイ・デザイン」と同様に、「最初期段階から組み込む」のがキーワードです!
3. 【要点整理】AIへの主な攻撃手法の比較表
試験で混同しやすい攻撃手法の分類、攻撃のタイミング、対策方法をまとめた比較表です。
| 攻撃手法 | 発生タイミング | 攻撃の目的・内容 | 主な対策手法 |
|---|---|---|---|
| 敵対的攻撃 (Adversarial Attack) | 運用・推論段階 | 微小なノイズを混ぜたデータ(敵対的サンプル)を入力し、AIを誤認識させる | ・敵対的学習(Adversarial Training) ・入力データの事前クレンジング |
| データ汚染 (Data Poisoning) | 学習・開発段階 | 悪意のあるデータを学習セットに混入させ、誤作動やバックドアを仕込む | ・学習データの出所チェック・検証 ・外れ値(異常データ)の検知・除去 |
| モデル窃取 (Model Extraction) | 運用・推論段階 | APIなどをを通じて大量の入出力を繰り返し、AIモデルの機能を複製(盗掘)する | ・連続アクセス(大量リクエスト)の制限 ・出力する予測確率の丸め処理 |
| データ窃取 (Data Extraction) | 運用・推論段階 | モデルの応答パターンから、学習に使用された非公開データや個人情報を特定する | ・差分プライバシー(Differential Privacy)の導入 ・過学習(Overfitting)の防止 |
💡 G検定合格の超重要ワンポイント
従来のITセキュリティ(FirewallやSSL暗号化など)だけでは、上記のような「入力データを工夫してAIをだます攻撃」を防ぐことはできません。
そのため、AI特有の脆弱性に合わせたアルゴリズム的対策(敵対的学習や差分プライバシーなど)と「セキュリティ・バイ・デザイン」の適用が不可欠となります!
4. G検定の「ひっかけ問題パターン」を総チェック!
G検定の選択肢で頻出の「ひっかけパターン」を用意しました。
罠を見破れるかチェックしてみましょう!
問題1(敵対的攻撃とデータ汚染のタイミングすり替え)
AIシステムのセキュリティに関する記述として、最も適切なものを1つ選びなさい。
- A. Adversarial Attack(敵対的攻撃)とは、AIの学習段階において悪意ある偽データを混入させ、モデルのパラメータを意図的に破壊する攻撃手法である。
- B. データ汚染(Data Poisoning)とは、すでに運用されているAIモデルの入力データには人間には識別できない微小なノイズを加え、推論結果を誤認識させる攻撃である。
- C. Adversarial Examples(敵対的サンプル)に対する有効な防御策の一つとして、あらかじめ攻撃用サンプルを学習データに含めて訓練する「敵対的学習」が存在する。
- D. AIモデルへの攻撃は従来のWebシステムと同じであるため、ファイアウォールを設置すればAI特有の誤認識攻撃も100%遮断できる。
【正解】 C
【解説】
Aは「データ汚染」、Bは「敵対的攻撃」の説明であり、定義とタイミングが逆になっています!
Dも従来のファイアウォールでは入力データ内の「微小なノイズ」を見抜けず遮断できないため誤りです。
Cの「敵対的学習が有効」というのが正しい記述です。
問題2(モデル窃取の仕組み)
モデル窃取(Model Extraction)攻撃に関する記述として、最も適切なものを1つ選びなさい。
- A. サーバー内に直接侵入し、保存されているAIのプログラムソースコードや重みパラメータファイルを物理的に盗み出す攻撃のこと。
- B. APIなどを通じて外部から大量の問い合わせを送信し、得られた入出力結果の組み合わせから、元のAIモデルと同等の機能を持つ代替モデルを再構築する攻撃のこと。
- C. AIモデルの出力を盗み見ることで、ユーザーのクレジットカード番号を直接解読する攻撃のこと。
- D. AIモデルに過剰なアクセス負荷をかけ、システムをダウンさせるDoS攻撃の一種のこと。
【正解】 B
【解説】
モデル窃取のポイントは「サーバーに侵入することなく、外部からのAPI入出力の観察(ブラックボックスアクセス)だけでモデルを模倣・複製する」という点です。
Aのような直接的な物理窃盗・ハッキングとは区別して覚えましょう。
問題3(セキュリティ・バイ・デザインの考え方)
AIシステム開発における「セキュリティ・バイ・デザイン」の説明として、最も適切なものを1つ選びなさい。
- A. AIシステムが完成し、本番環境にリリースされた後に、必要に応じてセキュリティ修正パッチを適用していく開発手法。
- B. 企画や要件定義、設計などの開発プロセスの最初期段階からセキュリティ対策を考慮し、システムに組み込んでいく設計思想。
- C. 外部の専門セキュリティ業者に、AIシステムの開発と運用をすべて丸投げ・完全委託する契約形態。
- D. AIのセキュリティ対策はイノベーションを遅らせるため、開発段階では一切考慮せずコストカットを最優先する思想。
【正解】 B
【解説】
セキュリティ・バイ・デザインは「企画・設計の初期段階からセキュリティを考慮・組み込む」ことが定義です。
後付けやリリース後の対応とするAは誤りです。
🔥 まとめ:AIの安全性とセキュリティを攻略してG検定合格へ!
今回はG検定の法律・倫理分野における最重要テーマ「安全性とセキュリティ」について解説しました。
- Adversarial Attack=人間に見えないノイズでAIをだます(推論時の攻撃)
- データ汚染=学習データに毒データを混ぜて誤作動させる(学習時の攻撃)
- モデル窃取=外からの大量の質問応答でモデルを完コピする
- 敵対的学習=敵対的サンプルをあらかじめ学習させて対策する
- セキュリティ・バイ・デザイン=企画・設計の最初期から安全性を組み込む
AI特有の攻撃手法と防衛策の仕組みをしっかり理解しておけば、本番のセキュリティ問題で迷うことはありません!
合格を目指して、自信を持って次のステップへ進んでいきましょう!応援しています!
【大人気💡】過去問風ミニテスト&関連テキスト
「安全性とセキュリティ」はバッチリ理解できましたか?
知識を確実に定着させて一発合格を引き寄せるために、今のあなたに最適なステップを選んで進んでみましょう!
合格率をグッと上げる!「過去問風ミニテスト」に挑戦
解説を読んだら、さっそく問題に挑戦して実力を確かめてみましょう!
ボタンをクリックするとミニテストのページが開きます。
🚀 最短ルートで合格を目指す!「厳選参考書」参考書をチョイス
G検定合格へのロードマップは、この一冊を机に置くことから始まります。まずは目次だけでもチェックしてみてください。
知識を『覚えたつもり』で終わらせない。この1冊を解き終える頃には、合格ライン突破に確実に近づきます。
関連項目の解説テキストを確認
【G検定対策】AIの公平性とバイアスを徹底解説!アルゴリズムバイアスと代理変数の覚え方
G検定で頻出の「AIと公平性」を分かりやすく解説!アルゴリズムバイアスやサンプリングバイアス、センシティブ属性と代理変数の関係をAmazonなどの著名事例で徹底整理。ひ…
- シラバス番号49:悪用